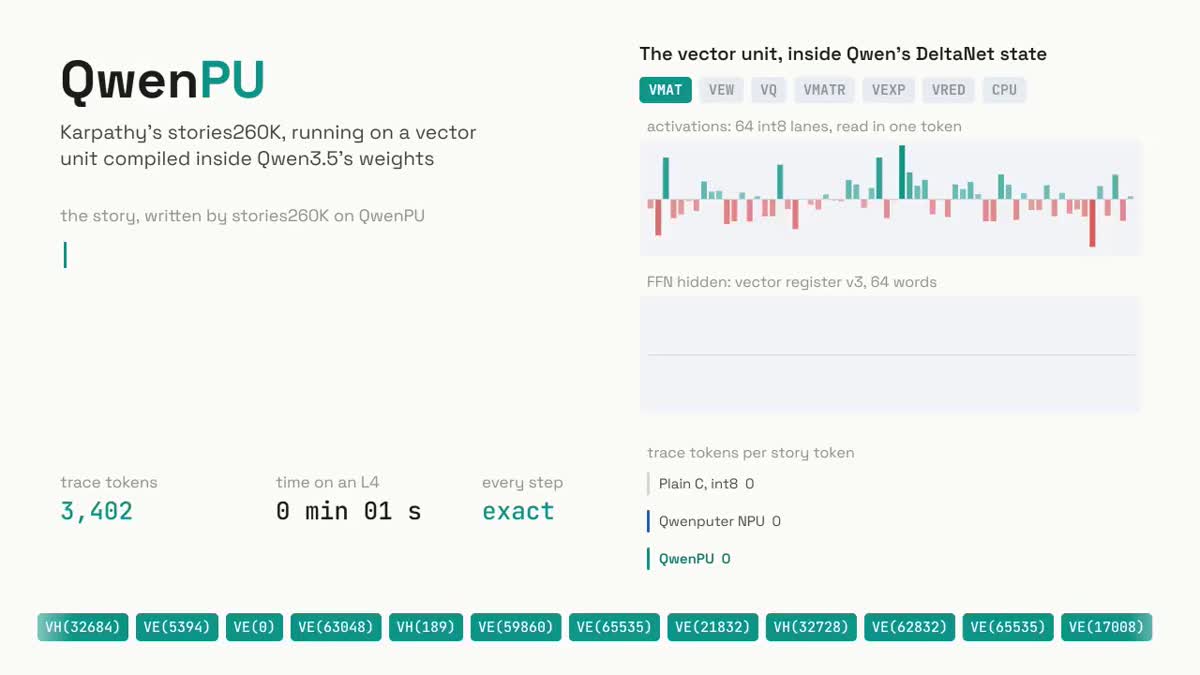
پروژه QwenPU نمونهای از اجرای یک مدل زبانی بزرگ درون یک مدل زبانی دیگر را به نمایش میگذارد. در این آزمایش، مدل stories260k روی یک NPU اجرا میشود که مستقیماً داخل وزنهای مدل Qwen 3.5-4B کامپایل شده است؛ رویکردی که مرز میان مدل زبانی، برنامه و واحد پردازشی را جابهجا میکند.
نکات کلیدی
- QwenPU نمونهای از اجرای یک LLM درون LLM دیگر است.
- مدل مورد استفاده همان پروژه stories260k از آندری کارپاتی است.
- مدل 260K در اصل یک برنامه نوشتهشده با زبان C است.
- یک NPU برای اجرای آن داخل وزنهای Qwen 3.5-4B کامپایل شده است.
- این NPU عملیات MatMul، Softmax و Attention را با دقت بیتبهبیت انجام میدهد.
QwenPU چگونه کار میکند؟
هسته این پروژه، کامپایل یک NPU درون وزنهای Qwen است. این واحد پردازشی عملیات ماتریسی، سافتمکس و اتنشن را انجام میدهد؛ همان عملیاتهایی که مدل 260K برای اجرا به آنها نیاز دارد.
مدل 260K خودش یک برنامه C است، اما برای اجرا داخل Qwen باید محیطی فراهم شود که محاسبات ضروری آن را انجام دهد. QwenPU این امکان را با پیادهسازی عملیات زیر فراهم کرده است:
- ضرب ماتریسی یا MatMul
- تابع Softmax
- سازوکار Attention
طبق توضیحات پروژه، این محاسبات با دقت Bit-exact یا بیتبهبیت انجام میشوند. جزئیات فنی و کد پروژه در مخزن QwenPU قرار گرفته است.
چرا این آزمایش جالب است؟
نکته متفاوت QwenPU فقط اجرای یک برنامه داخل مدل نیست؛ برنامه اجراشده خودش یک مدل زبانی است. بنابراین شما با ساختاری روبهرو هستید که در آن وزنهای یک LLM، NPU لازم برای اجرای LLM دیگری را در خود جای دادهاند.
این ایده از نظر مفهومی به پردازنده ۳۲ بیتی RISC-V درون وزنهای Qwen نزدیک است، اما اینبار هدف، فراهمکردن عملیات لازم برای اجرای یک مدل زبانی دیگر است.
جمعبندی
QwenPU آزمایشی غیرمعمول از ترکیب مدل و محاسبه است: یک NPU در وزنهای Qwen 3.5-4B قرار گرفته تا مدل stories260k را اجرا کند. اگر به آزمایشهای مرزی درباره قابلیتهای درونی LLMها علاقه دارید، این پروژه نمونهای قابلتوجه برای بررسی است.